

Il costo di una risposta di intelligenza artificiale può diminuire come aumenta la bolletta dell’utente. Tra abbonamento, volumi di testo elaborati, ricerche e ripetizioni, il prezzo visualizzato non è sufficiente per misurare il budget. Le aliquote ufficiali consultate il 10 novembre 2026 consentono di ripartire le spese, senza confondere una risposta economica con un lavoro adeguatamente completato.
Doporam#processoriebolletta elettricaLa serie di prezzi si occupa di una spesa meno visibile: quella del software che consuma il calcolo ad ogni uso. Per un’impresa indipendente, una piccola impresa o un’associazione, la domanda pratica è ciò che rimane incluso nel pacchetto e ciò che varia con l’attività.
Dal 2022 al 2024, un calo delle prestazioni definite
LAI Stanford 2025 Index, pubblicato il 7 aprile 2025, fornisce un punto di riferimento storico: il costo di mettere in discussione un modello che raggiunge GPT-3.5 sul test MMLU è aumentato da $20 per milione di chips nel novembre 2022 a $0.07 nell’ottobre 2024. La soglia è corretta del 64,8%. Il punto finale è Gemini-1.5-Flash-8B.
| Periodo | Dollari per milione di chips |
|---|---|
| Novembre 2022 | 20.00 |
| Ottobre 2024 | 0.07 |
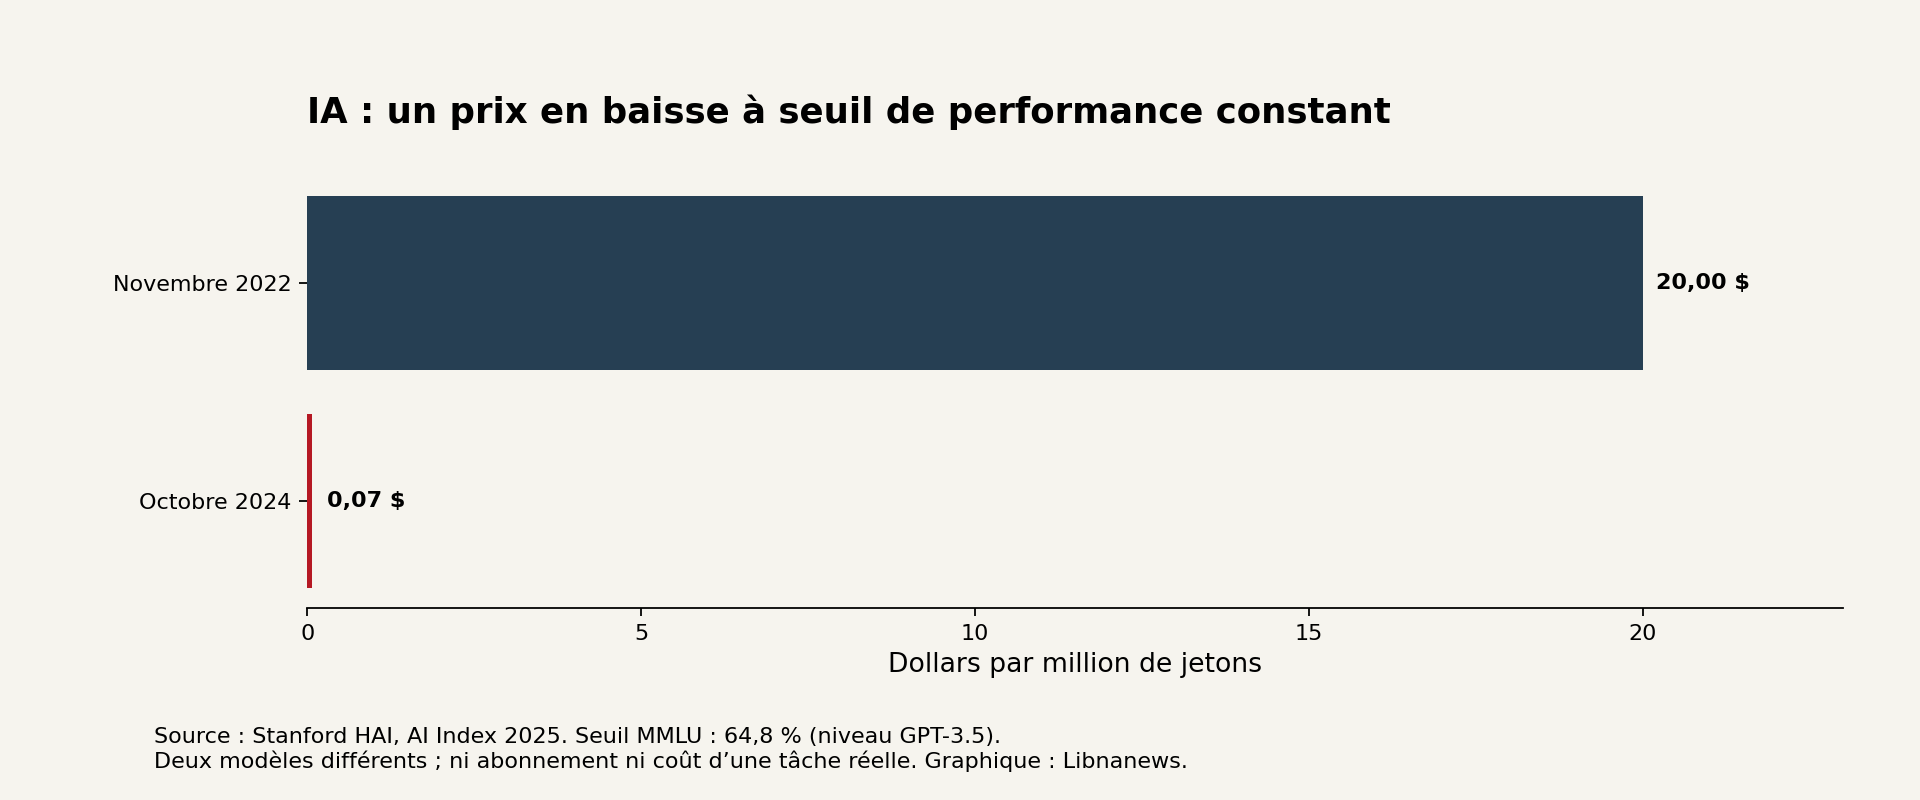
Si tratta di due osservazioni ad una determinata soglia di prestazione, non il prezzo dello stesso prodotto mantenuto per due anni. Non misurano il prezzo di un abbonamento o il successo di un agente in una società. Il rapporto supera i 280, ma non può essere esteso fino al 2026 senza mantenere lo stesso metodo. Le attuali tariffe qui sotto sono quindi una seconda tabella, separata da questa serie storica.
Abbonamento e consumo non pagano lo stesso
In un’applicazione, un abbonamento dà accesso alle funzioni e alla capacità di utilizzo. Un’API è un’interfaccia che permette ad un altro software di interrogare il modello; il suo consumo è generalmente contato. Una società che automatizza il trattamento dei documenti deve quindi leggere le condizioni dell’API, anche se i suoi dipendenti hanno già un abbonamento.
Theclaude grigliaillustra questa distinzione: Pro viene visualizzato a $20 al mese in pagamento mensile, o $200 pagato in anticipo per l’anno. Max costa $100 al mese e Ultra $200, escluse le imposte applicabili. I limiti di utilizzo rimangono; La quantità consumata dipende in particolare dal modello, dalla lunghezza delle conversazioni e dai file.
Tuttavia, sarebbe errato affermare che entrambe le fatture sono ancora completamente separate. Antropico ora pianicrediti API per gli abbonati selezionati: 100 dollari mensili per Max e 200 per Ultra, in condizioni di attivazione. Essi scadono alla fine del ciclo e non si riferiscono. Non coprono il codice Claude, i superamenti nelle applicazioni Claude, o piattaforme partner. Il loro importo non costituisce quindi uno sconto universale su tutti gli usi del marchio.
Un cestino identico di chips, non una promessa dello stesso risultato
Un token è un’unità di testo elaborata dal modello, non necessariamente una parola. L’ingresso comprende ciò che gli viene trasmesso; l’uscita corrisponde alla sua produzione fatturata. Per rendere leggibili le tariffe, la tabella seguente applica i prezzi di base ad un cestino puramente illustrativo: un milione di chip di ingresso non recuperati e 200.000 chip di uscita fatturabili, combinati su diverse domande brevi. Esclude strumenti, tasse, crediti promozionali, modalità accelerate e trattamenti a lungo termine.
| Modello | Entrata per milione | Produzione per milione | Costo del cesto |
|---|---|---|---|
| GPT-6 Luna | 0.10 | 0,50 | 0.20 |
| GPT-6.1 Soil | 2.00 | 10.00 | 4,00 |
| Claude Sonnet 5.5 | 2.00 | 10.00 | 4,00 |
| Claude Opus 5.5 | 4,00 | 20.00 | 8.00 |
| Claude Fable 5.2 | 8.00 | 40.00 | 16.00 |
Importi da griglieOpenAI, modalità standard e contesto breveeAntropico, tassi di base. Il calcolo è input + 0.2 × output. Due prezzi identici non significano due modelli intercambiabili. Lo stesso documento può anche produrre un numero diverso di chip a seconda del modello. Questa simulazione confronta le unità caricate; non classifica l’accuratezza, la velocità o il costo di un file effettivamente completato.
Perché le risposte lunghe pesano di più
Nel cesto $4, le entrate costano $2 e uscite $2. Tuttavia, ci sono cinque volte meno chip fuori. A questi tassi, che richiedono una produzione più lunga cambia rapidamente le spese. Se l’uscita aumenta da 200.000 a 400.000 monete, con la stessa entrata, il totale raggiunge $6, un aumento del 50%. Questo è un calcolo dello scenario, non una fattura osservata.
Le ricerche possono essere aggiunte. In particolare, la griglia OpenAI visualizza $10 per 1.000 chiamate di ricerca web standard, più fatturazione per il contenuto di ricerca trasmesso al modello. Mille ricerche non sono quindi confuse con mille semplici risposte testuali. Uno strumento che controlla diverse pagine, riformula e ripete può moltiplicare le stazioni di consumo prima di fornire alcuni paragrafi.
Riutilizzare un documento può ridurre il suo rebilling
Theistruzioni e documenti della cacheevitare di ricalcolare alcuni elementi già trattati. Si tratta di una parte comune situata all’inizio della richiesta, che deve rimanere identica. Mantenere una conversazione da sola non garantisce che questa riduzione si applica.
Per GPT-6.1 Sol, il tasso per la lettura della cache è $0.10 per milione di chips, rispetto a $2 per una voce ordinaria. Ma la scrittura iniziale nella cache ha anche un prezzo: $2.50 con il tempo di archiviazione standard di trenta minuti. Confrontare solo $0.10 a $2 eliminerebbe questa prima spesa.
Esempio semplificato: la stessa porzione di 100.000 token, completamente riutilizzabile, costa $0.25 per scrivere e $0.09 per nove letture. Il totale è di $0.34, rispetto a $2 per 10 retribuzioni regolari. Questo calcolo esclude le uscite e le nuove informazioni aggiunte; assume nove riuscite di successo prima della scadenza. Non descrive il prezzo di un’intera conversazione.
L’attesa può costare meno
La velocità è un’altra scelta economica. LBatch di OpenAI APIoffre una riduzione del 50% dalle chiamate sincrone, con una finestra di elaborazione 24 ore su 24. Il fornitore è responsabile in particolare della classificazione di grandi serie e valutazioni.
Per una società che archivia i suoi documenti di notte, questo periodo può essere accettabile. Per un servizio che risponde immediatamente a un cliente, cambia il servizio reso. L’importo inferiore paga quindi un altro vincolo di consegna. Tutte le riduzioni annunciate non devono essere aggiunte meccanicamente senza verificare che il modello e la modalità prescelti consentano loro.
Il giusto denominatore: il compito correttamente completato
Nella suaguida di ottimizzazioneAntropic raccomanda di confrontare il costo per compito completato piuttosto che l’unico prezzo di token. Un modello più a prezzi unitari può ridurre le ripetizioni; al contrario, utilizzando il più costoso per ogni classifica elementare può inutilmente aumentare il budget. I risultati presentati dal produttore rimangono unici ai suoi test e non sostituiscono un test sui documenti del cliente.
Il metodo concreto consiste nel prendere un campione stabile, definendo quale sia una risposta accettabile, e quindi identificare il consumo, gli errori e le correzioni. I file difficili devono rimanere in questo campione. Rimuoverli sarebbe artificialmente migliorare il costo medio e mascherare precisamente i casi che richiedono il maggior lavoro.
OpenAI identifica tre leve nella suaguida alla riduzione dei costi: limitare il numero di domande, ridurre i volumi di testo e scegliere un modello più piccolo quando l’accuratezza è sufficiente. Per il lettore, questo si traduce in semplici domande: devi restituire il file completo, ottenere dieci pagine invece di una sintesi, o riavviare l’intero compito per una sola correzione?
Il bilancio da seguire include diverse linee: possibile somma forfettaria, consumo netto dopo crediti effettivamente utilizzabili, strumenti e poi tempo di audit umano. Non c’è scala pubblica per assegnare un prezzo universale a questa ultima linea. È proprio per questo che un prezzo per milione di token, anche molto basso, non si permette di promettere un’economia sul lavoro finale.

Commenti